「量子コンピュータ」という言葉を聞く機会が増えた。
現在のスーパーコンピュータでは途方もない時間がかかる計算を、量子コンピュータなら短時間で解ける。
新薬の開発、材料設計、物流、金融、人工知能。
さらには、現在インターネットを守っている暗号さえ破る可能性があるとも言われている。
しかし、ここで一つ疑問がある。
そもそも量子コンピュータとは、何をしているコンピュータなのだろうか。
よく、
「普通のコンピュータは0か1だが、量子コンピュータは0と1を同時に扱える」
と説明される。
間違いではない。
しかし、それだけでは量子コンピュータの本質はほとんど分からない。
なぜなら、0と1を重ね合わせただけでは、答えを取り出すことはできないからだ。
量子コンピュータの本当の面白さは、その先にある。
今回は、量子コンピュータとは何なのか。
そしてなぜ世界中の企業や研究機関が、この奇妙な計算機の開発に巨額の資金を投入しているのか。
少し深く見ていこう。
普通のコンピュータは「0」と「1」で世界を計算している
まず、現在のコンピュータから考えてみよう。
スマートフォンもパソコンもスーパーコンピュータも、基本的には「ビット」と呼ばれる情報の単位を使っている。
ビットが取れる状態は、
0 または 1
だ。
大量の0と1を高速で切り替えながら、計算、画像処理、動画再生、AIなどを実行している。
スーパーコンピュータも基本原理は同じだ。
もちろん性能は桁違いだが、「0か1」という情報を処理する古典コンピュータであることには変わりない。
ところが量子コンピュータでは、この情報の単位そのものが違う。
使うのは、
量子ビット(qubit)
だ。
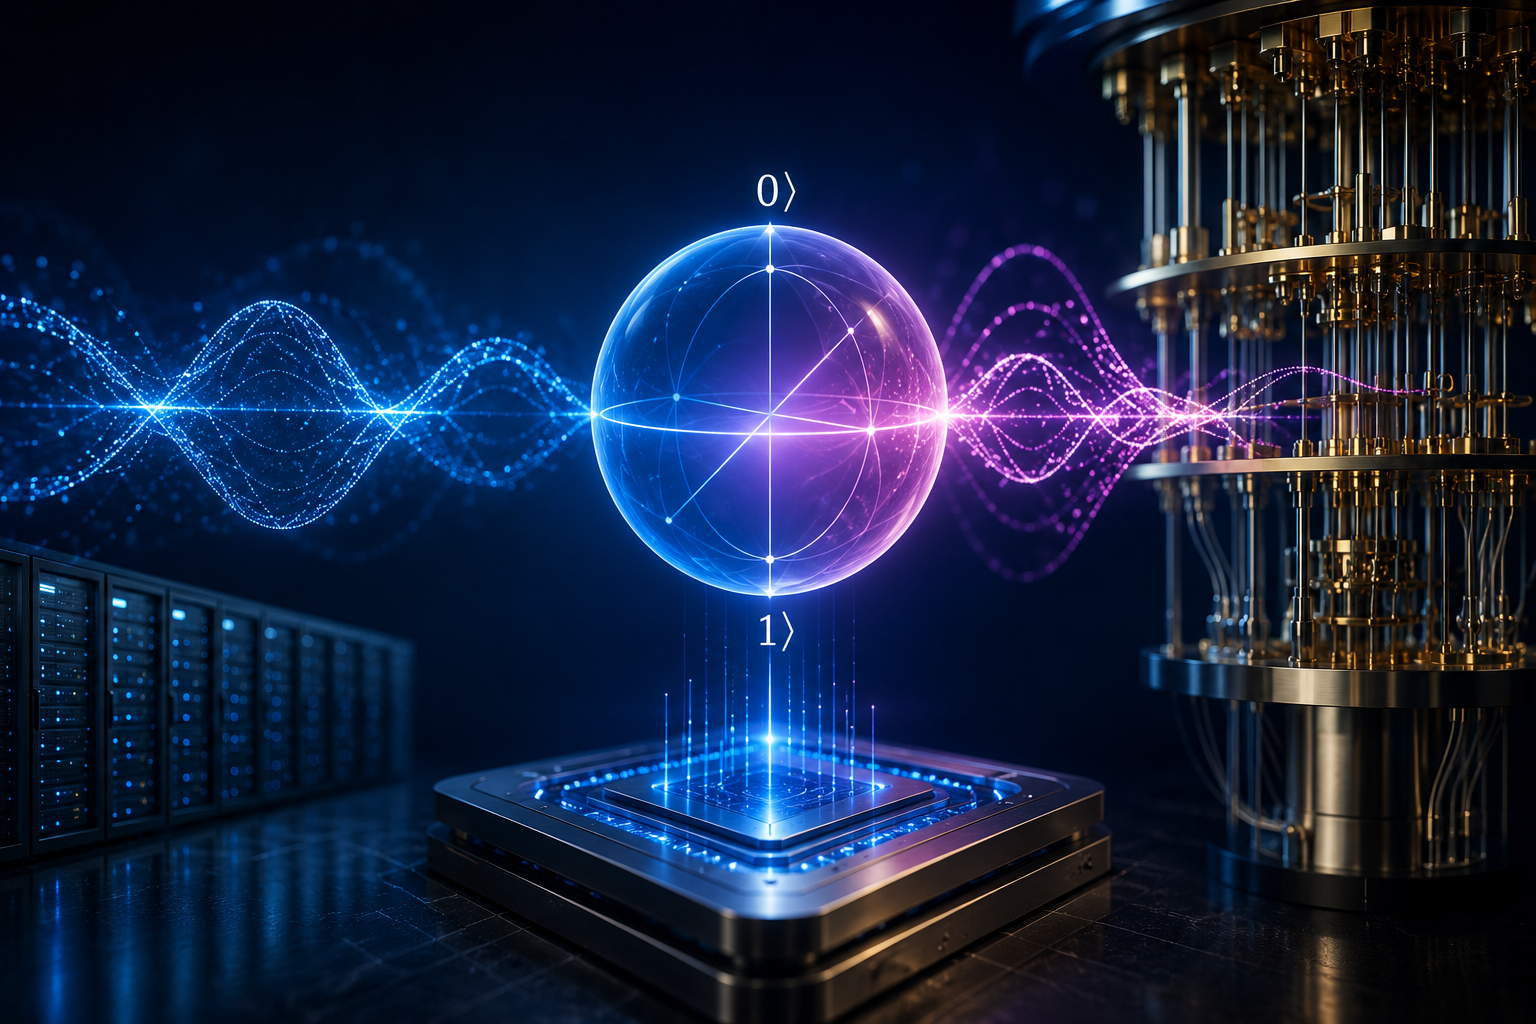
量子ビットは「0か1」ではない
量子ビットには、量子力学の性質が利用される。
その代表が、
重ね合わせ(superposition)
だ。
量子ビットは測定する前、0または1のどちらかに確定しているとは限らず、0と1に対応する状態の重ね合わせとして表現できる。
ただし、ここで注意したい。
よくある、
「0と1を同時に持っている」
という説明は、直感的には便利だが少し雑だ。
重ね合わせは、単に「0と1の両方が入っている箱」のようなものではない。
そして古典的な確率との決定的な違いがある。
量子状態には「干渉」が起きる。
これが重要になる。
量子コンピュータは「全部の答えを同時に出す機械」ではない
例えば複数の量子ビットを組み合わせると、非常に多くの状態を重ね合わせとして表現できる。
ここだけ聞くと、
「だったら全部の答えを同時に計算して、一気に答えを取り出せるのでは?」
と思いたくなる。
ところが、そうはいかない。
量子ビットを測定すると、得られるのは古典的な情報だ。
つまり最終的には0や1として読み出される。
重ね合わせの中に大量の情報が存在していても、それを全部そのまま取り出すことはできない。
そこで登場するのが、
量子干渉(quantum interference)
である。
量子状態は波のように、互いに強め合ったり打ち消し合ったりする性質を持つ。
量子アルゴリズムでは、この性質を利用して、
欲しい答えにつながる状態を強め、不要な状態を打ち消していく。
そして最後に測定する。
つまり量子コンピュータの強さは、
「大量の計算を全部同時にやること」
だけではない。
量子状態を巧みに操作し、干渉させることで、特定の問題について答えを取り出しやすい状態を作ることにある。
ここを理解すると、量子コンピュータのイメージが少し変わってくる。
もう一つの重要な性質「量子もつれ」
量子コンピュータを理解するうえで、もう一つ避けて通れないのが、
量子もつれ(entanglement)
だ。
複数の量子ビットがもつれると、それぞれを独立した状態として説明できなくなる。
一方の量子ビットだけを切り離して考えることができず、複数の量子ビットを一つの量子状態として扱う必要が出てくる。
重ね合わせ。
もつれ。
干渉。
こうした量子力学特有の性質を計算に利用する。
それが量子コンピュータだ。
量子コンピュータにも種類がある
ここで、もう一つ重要なことがある。
「量子コンピュータ」と一括りにされることが多いが、すべて同じ方式ではない。
大きく理解するなら、
量子ゲート方式
と
量子アニーリング方式
という二つの考え方がある。
量子ゲート方式
現在、多くの企業が汎用量子コンピュータを目指して開発しているのが量子ゲート方式だ。
普通のコンピュータが論理ゲートを組み合わせて計算するように、量子ゲートを使って量子ビットの状態を操作する。
IBM、Google、IonQ、Quantinuum、Rigettiなどが開発を進めている。
将来的に暗号解読で重要になるShorのアルゴリズムなども、基本的にはこのゲート型量子コンピュータの話になる。
量子アニーリング方式
一方、D-Waveが代表的なのが量子アニーリングだ。
こちらは、あらゆる計算を行う汎用コンピュータというより、
多数の候補の中から良い組み合わせを探す「最適化問題」
などを主な対象とする。
配送ルート。
人員配置。
生産計画。
スケジューリング。
ポートフォリオ。
こうした問題には膨大な組み合わせが存在する。
量子アニーリングでは、問題をエネルギー地形として表現し、低いエネルギー状態を探索することで解を求める。
つまり、
「量子コンピュータ」という名前が付いていても、目指しているものは必ずしも同じではない。
ここは量子関連ニュースを見るときにも重要になる。
さらに「量子ビットを何で作るか」も違う
話はもう少し複雑だ。
同じ量子ゲート方式でも、量子ビットを実際に何で作るのかについて複数の方式が競争している。
IBMやGoogleなどが研究する超伝導量子ビット。
IonQやQuantinuumなどが使うイオントラップ方式。
さらに中性原子、光子、シリコンスピンなど、さまざまな方式が研究されている。
例えばIonQでは、イオン化した原子を電磁場で空間に閉じ込め、レーザーを使って量子ゲートを操作する。
一方IBMは長く超伝導量子ビットを中心に開発してきたが、2026年7月にはシリコンスピン量子ビット技術を持つHRL Laboratoriesの買収に関する正式契約を締結した。
IBMは、HRLが持つシリコンスピン量子ビットや量子センシングの技術を取り込み、超伝導方式と並ぶ新たな量子技術の開発を進めようとしている。
つまり現在は、
「量子コンピュータを作れるか」
だけではなく、
「どの方式なら巨大な量子コンピュータまで拡張できるのか」
という競争も同時に起きている。
では、量子ビットを増やせば勝ちなのか
ここで量子コンピュータの記事によく出てくる数字がある。
「○○量子ビットを達成」
というものだ。
数字が大きいほど強そうに見える。
しかし、単純ではない。
量子状態は非常に壊れやすい。
外部からのノイズや制御のわずかな誤差によって、計算中にもエラーが発生する。
そのため重要になるのが、
量子誤り訂正(Quantum Error Correction=QEC)
だ。
「物理量子ビット」と「論理量子ビット」は違う
実際の装置に存在する量子ビットを、
物理量子ビット
と呼ぶ。
しかし、物理量子ビットにはエラーが発生する。
そこで複数の物理量子ビットを使って情報を符号化し、エラーを検出・訂正しながら、より信頼できる量子情報を扱う。
これが、
論理量子ビット
だ。
つまり、
1000物理量子ビット=1000個の完全な量子ビットを自由に使える
という意味ではない。
量子コンピュータを見るとき、単純な量子ビット数だけで性能を比較すると実態を見誤る可能性がある。
Google「Willow」が示した重要な一歩
量子誤り訂正で大きな話題になったのが、Googleの量子チップ「Willow」だ。
Googleは2024年、量子ビットを増やして誤り訂正コードを大きくすると、論理エラー率が低下する「below threshold」の実証を報告した。
3×3、5×5、7×7と物理量子ビットの配列を拡大するたび、エラー率を約半分に低減したという。
量子ビットを増やすほどエラーも増えてしまう――。
量子コンピュータ開発を長年悩ませてきた問題に対し、「規模を大きくしながら、逆にエラーを減らす」ことを示した重要な成果だった。
さらにWillowは、特定のベンチマーク計算を5分未満で実行したとGoogleは報告している。
ただし、ここにも注意が必要だ。
これは、
「量子コンピュータが普通のスーパーコンピュータより何でも速くなった」
という意味ではない。
特定の量子計算ベンチマークで示された結果であり、実社会のあらゆる計算が置き換わったわけではない。
そしてここから、量子コンピュータについて非常に重要な疑問が出てくる。
量子コンピュータが完成したら、スーパーコンピュータはいらなくなるのか
おそらく、そうはならない。
むしろ現在の開発方向を見ると、逆だ。
量子コンピュータとスーパーコンピュータは、一緒に使われようとしている。
IBMが掲げているのが「Quantum-Centric Supercomputing」という考え方だ。
そこでは、
CPU
GPU
QPU(Quantum Processing Unit)
という異なる計算装置を組み合わせ、一つの計算環境として利用する。
普通の計算はCPU。
大規模な並列計算はGPU。
量子計算が有利な部分はQPU。
そして必要に応じて結果を再び古典コンピュータ側で処理する。
つまり量子コンピュータは、
スーパーコンピュータを置き換える次世代コンピュータ
というより、
スーパーコンピュータに新しい種類の計算装置が加わる
と考えた方が現実に近い。
GPUが登場してもCPUが消えなかったように、QPUも特定の計算を担当するアクセラレータとして組み込まれていく可能性がある。
IBM自身、2026年のロードマップで、量子ハードウェアとHPCを組み合わせ、最初の「quantum advantage」の例を示すことを目標としている。
日本ではすでに「富岳」と量子コンピュータがつながっている
これは未来の構想だけではない。
日本でもすでに始まっている。
理化学研究所では、スーパーコンピュータ「富岳」と複数方式の量子コンピュータを組み合わせる量子-HPCハイブリッド計算の研究を進めている。
2025年にはQuantinuumのイオントラップ型量子コンピュータ「黎明」が稼働。
同年にはIBM Quantum System Two「ibm_kobe」も神戸に導入され、「富岳」と直接接続した量子・古典融合ワークフローの開発が進められている。
さらに2026年6月には、新たな量子-HPC向けGPUスーパーコンピュータ「ROQUO(ろっこう)」が稼働した。
ROQUOは「富岳」、IBM Quantum System Two、そして「黎明」と連携し、量子コンピュータとHPCを密結合させた計算環境の実証に使われる。
つまり日本でも、
スーパーコンピュータ vs 量子コンピュータ
ではなく、
スーパーコンピュータ + 量子コンピュータ
という方向へすでに進んでいる。
量子コンピュータは「速いコンピュータ」ではない
ここまで見てくると、量子コンピュータについて最初に持っていたイメージとはかなり違って見える。
量子コンピュータは、
現在のコンピュータを単純に高速化した機械ではない。
計算そのものの方法が違う。
そして、すべての問題が速くなるわけでもない。
量子力学の性質をうまく利用できる問題について、古典コンピュータとは異なる計算方法を使える。
だからこそ未来の計算環境は、
CPU+GPU+QPU
という異なる計算装置を組み合わせたものになる可能性が高い。
そして世界の巨大テクノロジー企業は、その未来に巨額の資金を投入し始めている。
IBMは2026年6月、量子コンピューティングに今後5年間で100億ドル超を投資する計画を発表した。
研究開発だけではない。
設備投資、製造能力の拡大、M&A、量子技術を取り巻くエコシステムの構築まで含む大規模な投資だ。
同社の現在のロードマップでは、2029年に200論理量子ビットで1億量子ゲートを実行できる耐故障量子コンピュータ「Starling」を提供することを目標としている。
さらに2033年以降には、
最大2,000論理量子ビット
10億量子ゲート
を目標とする「Blue Jay」へ拡張するロードマップを描いている。
もちろん、これらは現時点での開発目標であり、実現時期や性能が保証されたものではない。
それでも、
5年間で100億ドル超。
200論理量子ビット。
1億量子ゲート。
その先には2,000論理量子ビットと10億量子ゲート。
こうした数字を見ると、量子コンピュータが単なる研究室の実験装置ではなく、次の計算インフラをめぐる巨大な技術競争になっていることが分かる。
量子コンピュータは、すでに存在する。しかし完成してはいない
量子コンピュータは、すでに存在する。
クラウドを通じて実際の量子コンピュータを利用することさえできる。
しかし、
本当に大規模で、
誤り訂正され、
社会を変えるほどの計算を安定して実行できる量子コンピュータ
は、まだ開発の途中にある。
それでも世界中の政府や企業が巨額の資金を投入している。
なぜなのか。
理由の一つが、量子コンピュータが十分に発達したとき、現在社会を支えているある重要な技術が脅かされる可能性があるからだ。
暗号である。
現在インターネットで使われている公開鍵暗号の一部は、
「普通のコンピュータでは解くのに途方もない時間がかかる」
という前提によって安全性を保っている。
しかし量子コンピュータには、その前提を崩す可能性がある。
しかも問題は、
量子コンピュータが完成してから対策を始めればいい
というほど単純ではない。
世界ではすでに、その日に備えた「暗号の交換」が始まっている。
次回は、
【第2回】量子コンピュータとは何なのか――なぜ現在の暗号を破れると言われているのか
Shorのアルゴリズムと現在の暗号が成立している仕組みから、その理由を考えてみたい。